 UFO
Las entrevistas
Una entrevista es una conversación con un testigo. El caso conserva lo que estableció y puede conservar su transcripción.
Un investigador rara vez se queda en el primer relato de un testigo. Vuelve a él: para fijar una cifra, preguntar lo que no se dijo, comprobar lo que no cuadra. Esa conversación es una entrevista, y un caso puede guardarla junto a los relatos de los que habla.
Una entrevista es una conversación mantenida con uno o varios testigos del caso, por una o varias personas (un investigador, una asociación), en un momento dado y por algún medio: en persona, por teléfono, videollamada, chat, correo electrónico o carta. Lo que el caso conserva de ella es lo que estableció (una breve descripción, en tantos idiomas como se quiera) y, cuando existe, su transcripción: quién dijo qué y cuándo. La transcripción es lo que un lector puede contrastar con la descripción.
Varios entrevistadores, varios testigos#
Una entrevista puede tener cualquier número de hablantes. by enumera cada entrevistador e interviewOf cada observación con la que se celebró; en el archivo, el primer entrevistador es interviewer, el siguiente interviewer2, y lo mismo witness, witness2… El editor los mantiene de acuerdo con el evento.
Su lugar en el caso#
Un caso contiene eventos. Una entrevista es uno de ellos y remite a la observación del testigo con quien se celebró (a las observaciones, cuando se entrevistó a varios testigos juntos). La remisión va en ambos sentidos: un pasaje de la transcripción puede decir de qué momento de la observación habla, y la observación enumera entonces, en ese momento, los pasajes que la cuentan. Nada de una entrevista se reproduce: la observación es lo que se reproduce, la entrevista es lo que explica sus cifras.
Un turno puede decir de qué momento de la observación habla: "refs": [{ "at": 0.5 }], en segundos desde el inicio de la observación. sighting nombra la observación cuando la entrevista se celebró con varias, y range ([desde, hasta] en caracteres de text) la parte del turno afectada. En el editor, un turno con referencia tiene un botón que muestra la observación en ese momento, y la observación enumera debajo los pasajes que la cuentan («Relatado en …»), cada uno un enlace de vuelta al turno.
Eliminar pasajes#
Una transcripción publicada puede contener menos de lo grabado: la vida privada, un nombre, un lugar exacto. Lo eliminado conserva su sitio (hablante y tiempos) y dice por qué en reason, de modo que el lector ve un hueco y su razón en lugar de un corte silencioso. Cuando solo se va un detalle, usa parts: la respuesta a «¿hay luces en el parque?» se queda, las calles que identificarían el lugar se van.
Quién la aprobó#
Una transcripción está revisada cuando cada hablante la ha aprobado. proofreading da a cada hablante un status: pending (no se pidió o sin respuesta), approved o covered. covered es para un archivo que contiene menos de lo que el hablante ya aprobó (pasajes eliminados, nada añadido): basta la aprobación anterior del conjunto, y coveredBy nombra esa versión más completa. Un hablante que no figura no ha aprobado.
En el editor de entrevistas#
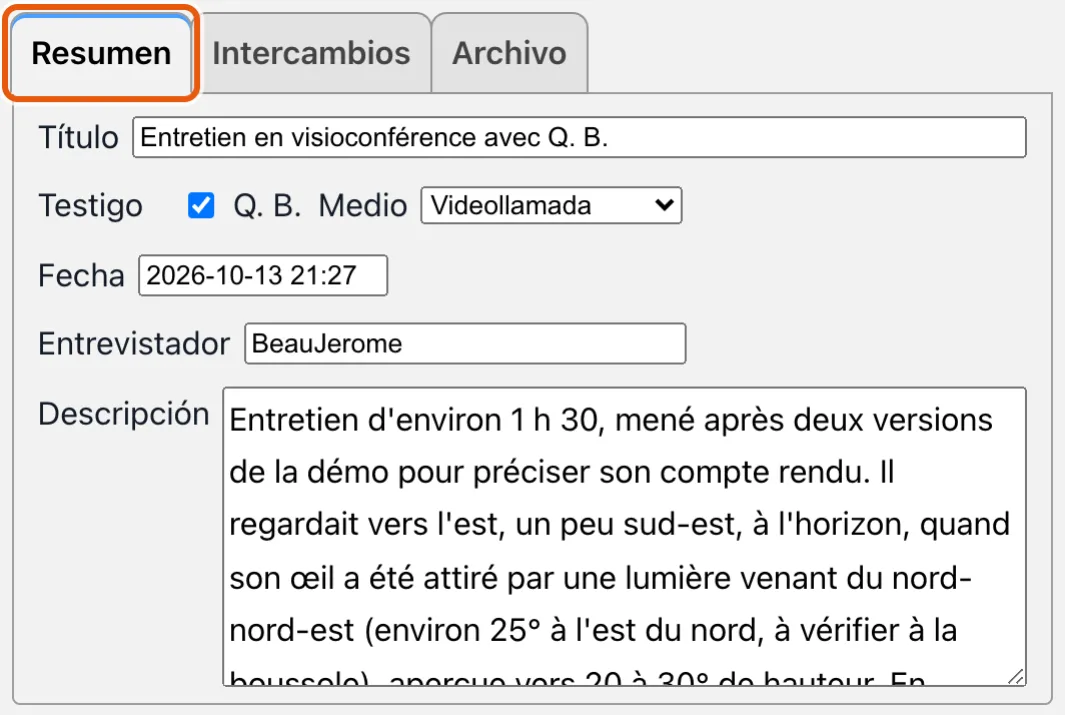
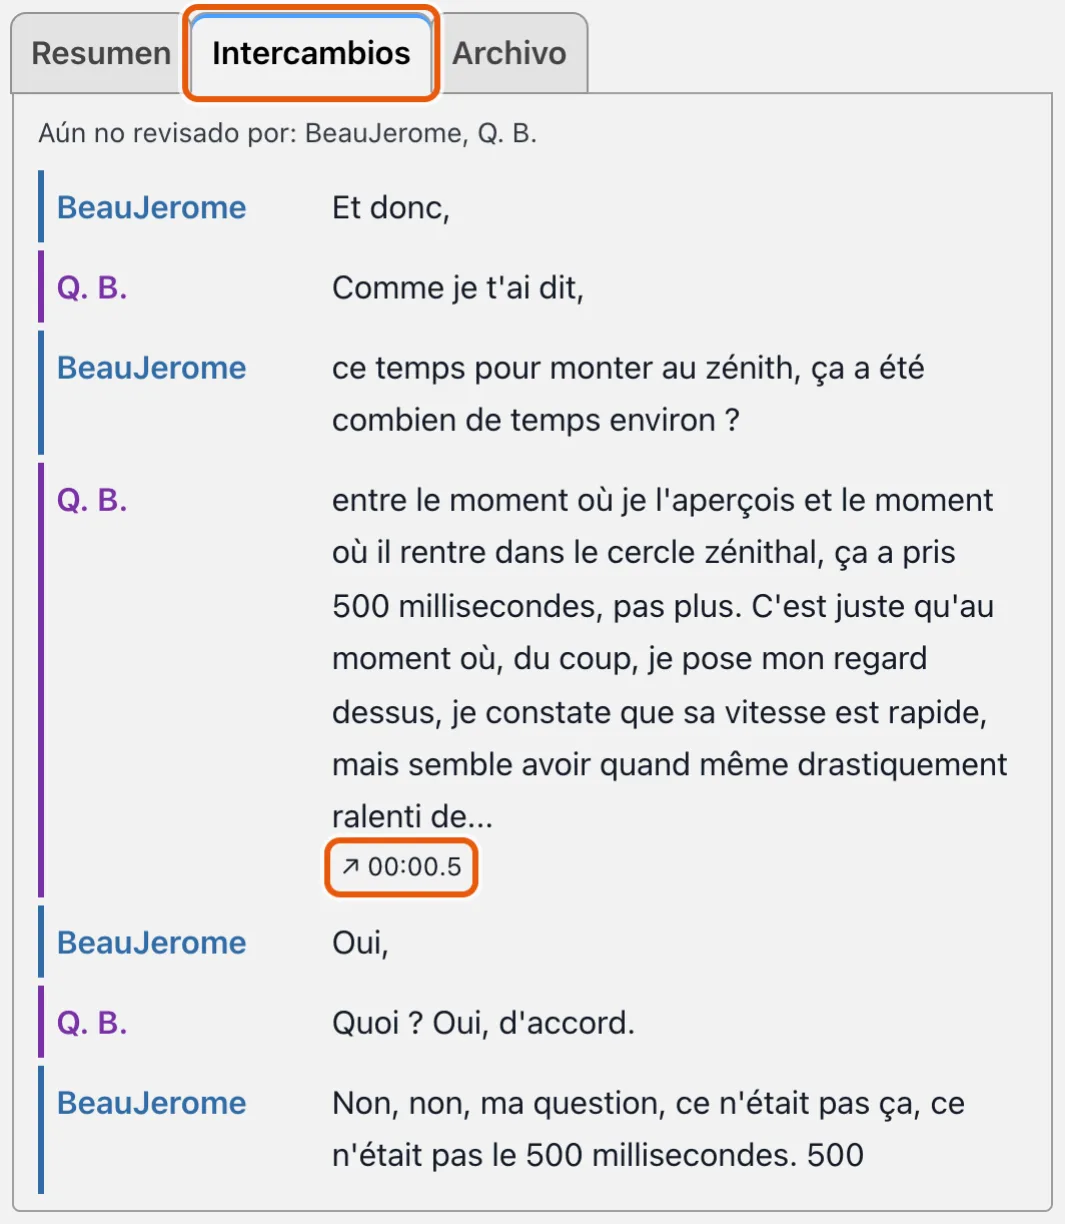
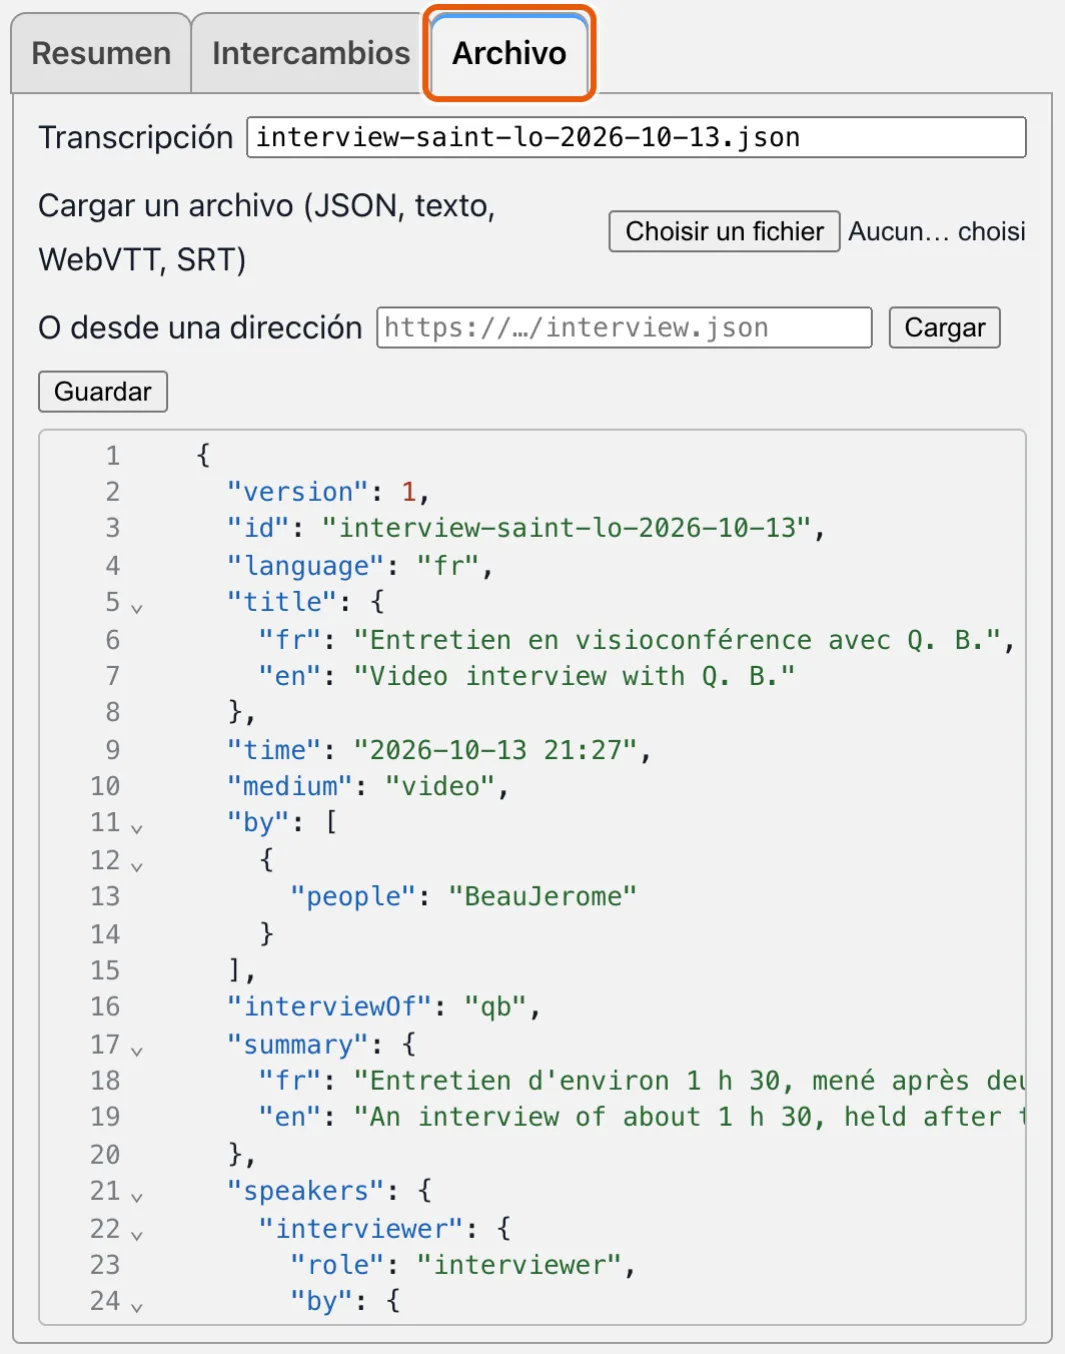
<rr0-interview-editor> tiene tres grupos: el Resumen (título, testigos, medio, fecha, entrevistadores, descripción), los Intercambios (la entrevista leída como un diálogo: quién dijo qué, el tiempo de cada turno en un globo, los pasajes eliminados ennegrecidos con su razón, quién aún no ha aprobado) y el Archivo (la transcripción como texto, completada según su esquema, para cargar y guardar). Es un fragmento aparte, que se descarga solo cuando un caso tiene una entrevista.
Importar una transcripción que no está en nuestro formato#
La mayoría de las transcripciones vienen de otra parte. En el grupo Archivo, «Cargar un archivo» lee, además de JSON:
- WebVTT y SRT, como los escribe una herramienta de grabación o un editor de subtítulos: se conservan los tiempos, el hablante es la etiqueta
<v Nombre>o unNombre:antes del texto; - texto o Markdown con un nombre antes de cada turno:
Nombre: …,[00:12:34] Nombre: …,Nombre (00:12:34): …,Q:/R:oQ./A.; una línea sin nombre continúa el turno anterior; - simples párrafos: un turno cada uno, sin hablante ni tiempo.
Los nombres hallados se emparejan con los de la entrevista: uno que figura entre quienes la realizaron es un entrevistador, uno que es testigo del caso es ese testigo. Si no, el primero en hablar es el entrevistador y los demás testigos; Q siempre pregunta y R o A siempre responde. Todos quedan pendientes de aprobación (pending), y la nota dice de qué archivo procede.
Adivina, y lo dice: lo que falla se corrige en el grupo Archivo. Los archivos de procesador de texto y los PDF no se leen: guárdalos antes como texto. Unos dos puntos en una frase no se toman por un hablante mientras un nombre no se repita lo bastante.
Parte técnica: los archivos#
Lo que sigue es para quien escribe estos archivos a mano, los genera o los lee en código. En el editor no hace falta saber nada de ello.
El evento en el caso#
En case.json, una entrevista es un evento cuyo eventType es "interview".
| Campo | Significado |
|---|---|
id | Con lo que otras cosas se refieren a ella |
time | Cuándo se celebró, como el caso escribe una fecha |
title | Cómo se llama, en tantos idiomas como se quiera |
summary | Lo que estableció, del mismo modo |
medium | in-person, phone, video, chat, email, letter u other |
by | Quién la realizó: un agente o varios ({ "people": "…" } o { "org": "…" }) |
interviewOf | El id de la observación con la que se celebró, o una lista si hubo varios testigos |
url | El archivo de transcripción, si lo hay, relativo al caso |
El archivo de transcripción#
Un archivo JSON simple, cuyo esquema es interview.schema.json. Contiene todo lo que el evento dice de la entrevista (el resumen y el archivo se mantienen iguales, se edite el que se edite) Y lo que se dijo.
| Campo | Significado |
|---|---|
version, id, language | 1; el id de la entrevista; el idioma en que se celebró |
title, time, medium, by, interviewOf, summary | Los mismos que los del evento |
speakers | Quién habla, con un id a tu elección: { role, by?, title?, of? }. role es interviewer o witness; by el agente del entrevistador; title cómo se llama un testigo (sus iniciales si no se nombra) y of la observación que dio |
transcription | Cómo se obtuvo el texto: method (automatic o manual), engine y una note libre |
proofreading | Quién la aprobó, por hablante (véase más abajo) |
anonymization | Lo que se sustituyó (replaced) y lo que ocupa su lugar (marker) |
segments | Los turnos de palabra, en orden |
Un turno de palabra
Cada entrada de segments es un turno.
| Campo | Significado |
|---|---|
speaker | Una clave de speakers |
start, end | Segundos desde el inicio de la grabación, ambos opcionales: una transcripción escrita a mano no los tiene, y un turno sin tiempo no está en los subtítulos |
text | Lo que se dijo, como texto plano o HTML (un enlace, un título en cursiva, una palabra extranjera en su idioma: lo que escribiría una página que lo publica), escapado como cualquier cadena JSON. El formato dice quién habla y cuándo; el resto es cosa del HTML |
redacted | { reason }: el turno entero se eliminó del archivo publicado. Entonces no tiene text |
parts | En lugar de text, cuando solo se eliminó un tramo: una lista de { text } y { redacted }, en orden |
refs | Los momentos de la observación que cuenta este turno (véase «Vínculos con la observación») |
Cada extracto de abajo es de solo lectura, y cada uno conoce el formato: pon el cursor dentro de un objeto y pulsa Ctrl+Espacio (⌥+I en Mac) para listar todas las claves que podrían ir ahí, con lo que el modelo dice de cada una.
Un ejemplo
{
  "version": 1,
  "id": "interview-qb-1",
  "language": "fr",
  "title": { "fr": "Entretien avec Q. B." },
  "time": "2026-10-13 21:27",
  "medium": "video",
  "by": [{ "people": "BeauJerome" }],
  "interviewOf": "qb",
  "speakers": {
    "interviewer": { "role": "interviewer", "by": { "people": "BeauJerome" } },
    "witness": { "role": "witness", "title": "Q. B.", "of": "qb" }
  },
  "transcription": { "method": "automatic", "engine": "whisper.cpp large-v3-turbo" },
  "proofreading": { "interviewer": { "status": "approved" }, "witness": { "status": "pending" } },
  "segments": [
    { "speaker": "interviewer", "start": 0, "end": 4.2, "text": "Où étiez-vous ?" },
    { "speaker": "witness", "start": 5, "end": 9, "text": "Dans le parc.", "refs": [{ "at": 0.5 }] },
    { "speaker": "witness", "start": 10, "end": 18, "parts": [
      { "text": "Il n'y en a pas." },
      { "redacted": { "reason": { "fr": "Lieu précis" } } }
    ] },
    { "speaker": "interviewer", "start": 20, "end": 40, "redacted": { "reason": { "fr": "Vie privée" } } }
  ]
}
En código#
@rr0/data lee y escribe los mismos archivos: RR0Interview.fromEventJson / toEventJson para el evento, fromFileJson / toFileJson para el archivo, y proofread dice si todos aprobaron. En UFO@home, InterviewFile.toVtt hace subtítulos de una transcripción, InterviewFile.passagesAbout enumera los turnos que cuentan una observación e InterviewImport.parse lee un archivo ajeno.
<rr0-interview>
Una entrevista leída como un diálogo: quién dijo qué, tal como lo dice su HTML, los pasajes retirados como barras que dicen por qué, la hora de cada turno al pasar el puntero, y los pasajes que cuentan un momento de la observación como botones que llevan a él. Dibuja en la propia página, no en una raíz oculta: los estilos de la página alcanzan el texto y sus enlaces.
<script src="https://ufoathome.org/lib/rr0-interview.mjs" type="module"></script>
<rr0-sighting id="player" src="case.json"></rr0-sighting>
<rr0-interview src="interview.json" player="player"></rr0-interview>
Un módulo aparte, ligero: contiene el diálogo y nada de la escena ni de los editores.
| Miembro | Tipo | Qué hace |
|---|---|---|
src | atributo | El archivo de la entrevista, relativo a la página. Sus enlaces son relativos a él. |
player | atributo | El id de un <rr0-sighting> de la página: un pasaje seguido hasta su momento muestra allí la observación, en ese momento. |
interview | propiedad | La entrevista mostrada, dada directamente en lugar de leída. |
documentUrl | propiedad | Aquello a lo que son relativos los enlaces de una entrevista dada directamente. |
revealSegment(index) | método | Muestra ese turno y dónde está. |
interviewseek | evento | Enviado, y propagado, cuando un lector sigue un turno hasta el momento de la observación que cuenta: detail es { sighting, at }. |
<rr0-interview-editor>
El editor de una entrevista de un caso: su resumen, sus intercambios y su archivo de transcripción. El editor de casos lo muestra en lugar del editor de grabaciones cuando se elige una entrevista.
const interview = document.createElement("rr0-interview-editor")
interview.documentUrl = "https://example.org/cases/saint-lo/case.json"
interview.witnesses = [{ id: "qb", label: "Q. B." }]
interview.event = { type: "event", eventType: "interview", interviewOf: "qb" }
interview.addEventListener("interviewchange", event => console.log(event.detail.field))
No es un módulo aparte: el del editor de casos lo descarga, y lo define, la primera vez que se muestra una entrevista, ya que la mayoría de los casos no tienen ninguna.
| Miembro | Tipo | Qué hace |
|---|---|---|
event | propiedad | El evento del caso que es la entrevista, editado en su sitio. |
witnesses | propiedad | Los observadores con quienes pudo celebrarse, [{ id, label }]: una casilla cada uno, al menos una marcada. |
documentUrl | propiedad | Aquello a lo que es relativa la url de la transcripción: la dirección del caso. |
transcriptText | propiedad | La transcripción como texto, una vez editada o cargada; indefinida hasta entonces, cuando se lee de la url del evento. |
readonly | atributo | Solo muestra la entrevista. |
revealSegment(index) | método | Abre el grupo Intercambios en ese turno y muestra dónde está. |
interviewchange | evento | Enviado, y propagado, en cada edición: detail es { field, event, text? }, con el texto de la transcripción en text. |
interviewseek | evento | Enviado, y propagado, cuando un lector sigue un turno hasta el momento de la observación que cuenta: detail es { sighting, at }, con at en segundos desde el inicio de la observación. |