 UFO
Le interviste
Un'intervista è una conversazione con un testimone. Il caso conserva ciò che ha stabilito e può conservarne la trascrizione.
Un investigatore raramente si ferma al primo resoconto di un testimone. Torna da lui: per fissare un valore, chiedere ciò che non è stato detto, verificare ciò che non torna. Quella conversazione è un'intervista, e un caso può conservarla accanto ai resoconti di cui parla.
Un'intervista è una conversazione condotta con uno o più testimoni del caso, da una o più persone (un investigatore, un'associazione), in un dato momento e con un certo mezzo: di persona, per telefono, in videochiamata, in chat, per email o per lettera. Ciò che il caso ne conserva è ciò che ha stabilito (una breve descrizione, in quante lingue si vuole) e, quando c'è, la sua trascrizione: chi ha detto che cosa e quando. La trascrizione è ciò con cui un lettore può confrontare la descrizione.
Più intervistatori, più testimoni#
Un'intervista può avere un numero qualsiasi di parlanti. by elenca ogni intervistatore e interviewOf ogni osservazione con cui si è tenuta; nel file il primo intervistatore è interviewer, il successivo interviewer2, e così witness, witness2… L'editor li tiene allineati all'evento.
Il suo posto nel caso#
Un caso contiene eventi. Un'intervista è uno di essi e rimanda all'osservazione del testimone con cui si è tenuta (alle osservazioni, quando più testimoni sono stati intervistati insieme). Il rimando va in entrambe le direzioni: un passaggio della trascrizione può dire di quale momento dell'osservazione parla, e l'osservazione elenca allora, in quel momento, i passaggi che la raccontano. Nulla di un'intervista viene riprodotto: l'osservazione è ciò che si riproduce, l'intervista è ciò che ne spiega i valori.
Un turno può dire di quale momento dell'osservazione parla: "refs": [{ "at": 0.5 }], in secondi dall'inizio dell'osservazione. sighting nomina l'osservazione quando l'intervista ne riguarda più d'una, e range ([da, a] in caratteri di text) la parte del turno interessata. Nell'editor un turno con un riferimento ha un pulsante che mostra l'osservazione in quel momento, e l'osservazione elenca sotto i passaggi che la raccontano («Riportato in …»), ciascuno un link di ritorno al turno.
Togliere dei passaggi#
Una trascrizione pubblicata può contenere meno di quanto registrato: la vita privata, un nome, un luogo esatto. Ciò che viene tolto conserva il proprio posto (parlante e tempi) e dice perché in reason, così che il lettore veda un vuoto e la sua ragione anziché un taglio silenzioso. Quando se ne va solo un dettaglio, usa parts: la risposta a «ci sono luci nel parco?» resta, le vie che identificherebbero il luogo se ne vanno.
Chi l'ha approvata#
Una trascrizione è rivista quando ogni parlante l'ha approvata. proofreading dà a ogni parlante uno status: pending (non richiesto o senza risposta), approved o covered. covered vale per un file che contiene meno di quanto il parlante ha già approvato (passaggi tolti, nulla aggiunto): basta l'approvazione precedente dell'insieme, e coveredBy nomina quella versione più completa. Un parlante non elencato non ha approvato.
Nell'editor di interviste#
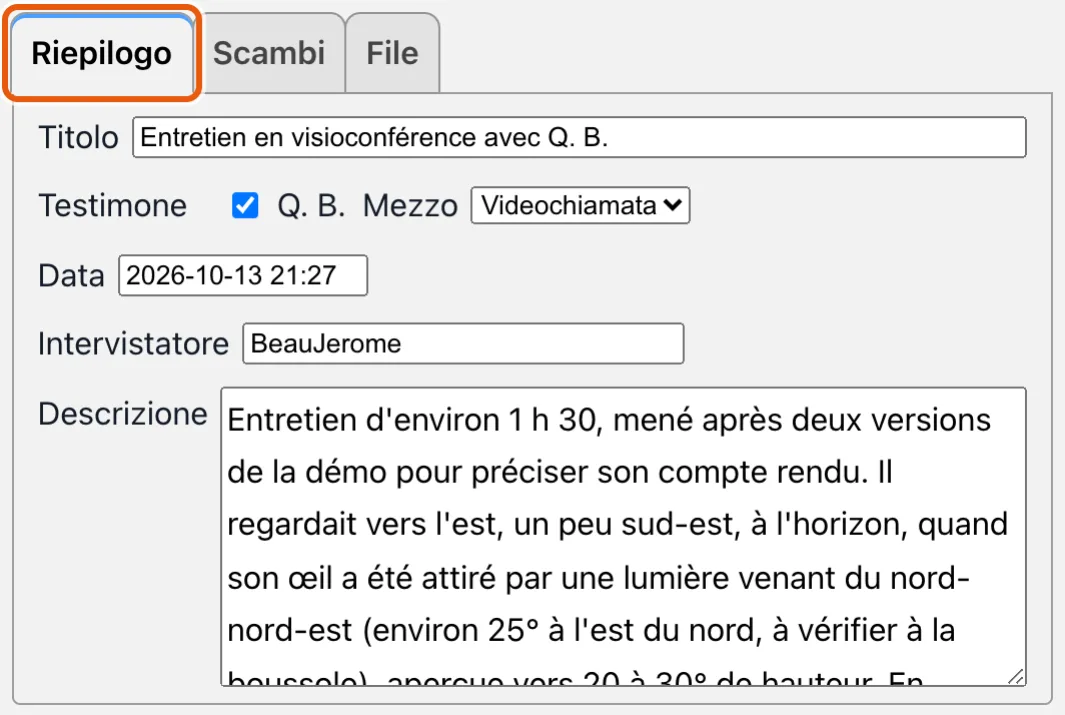
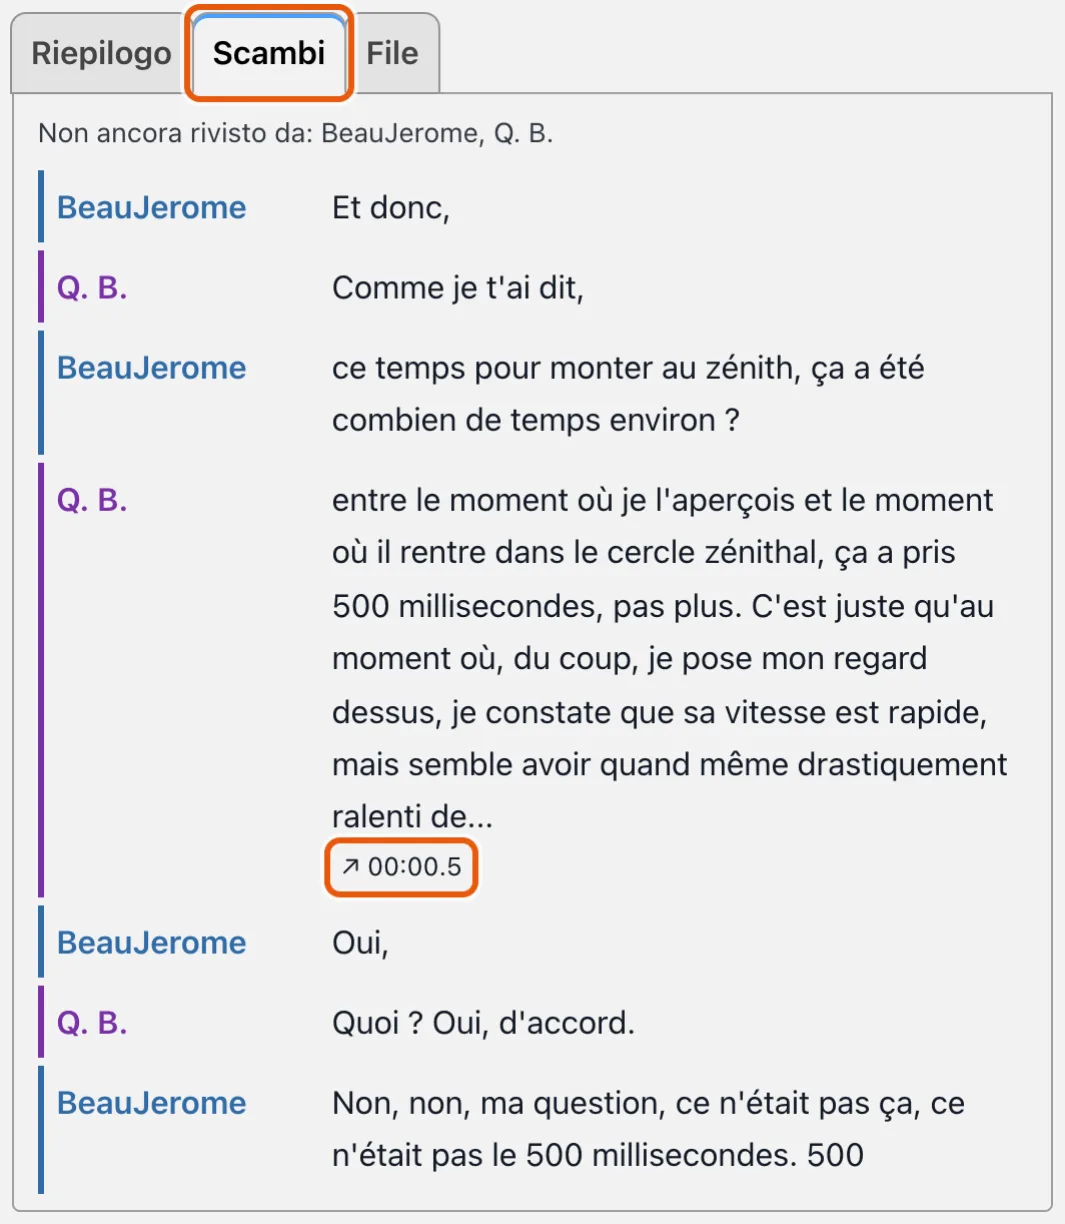
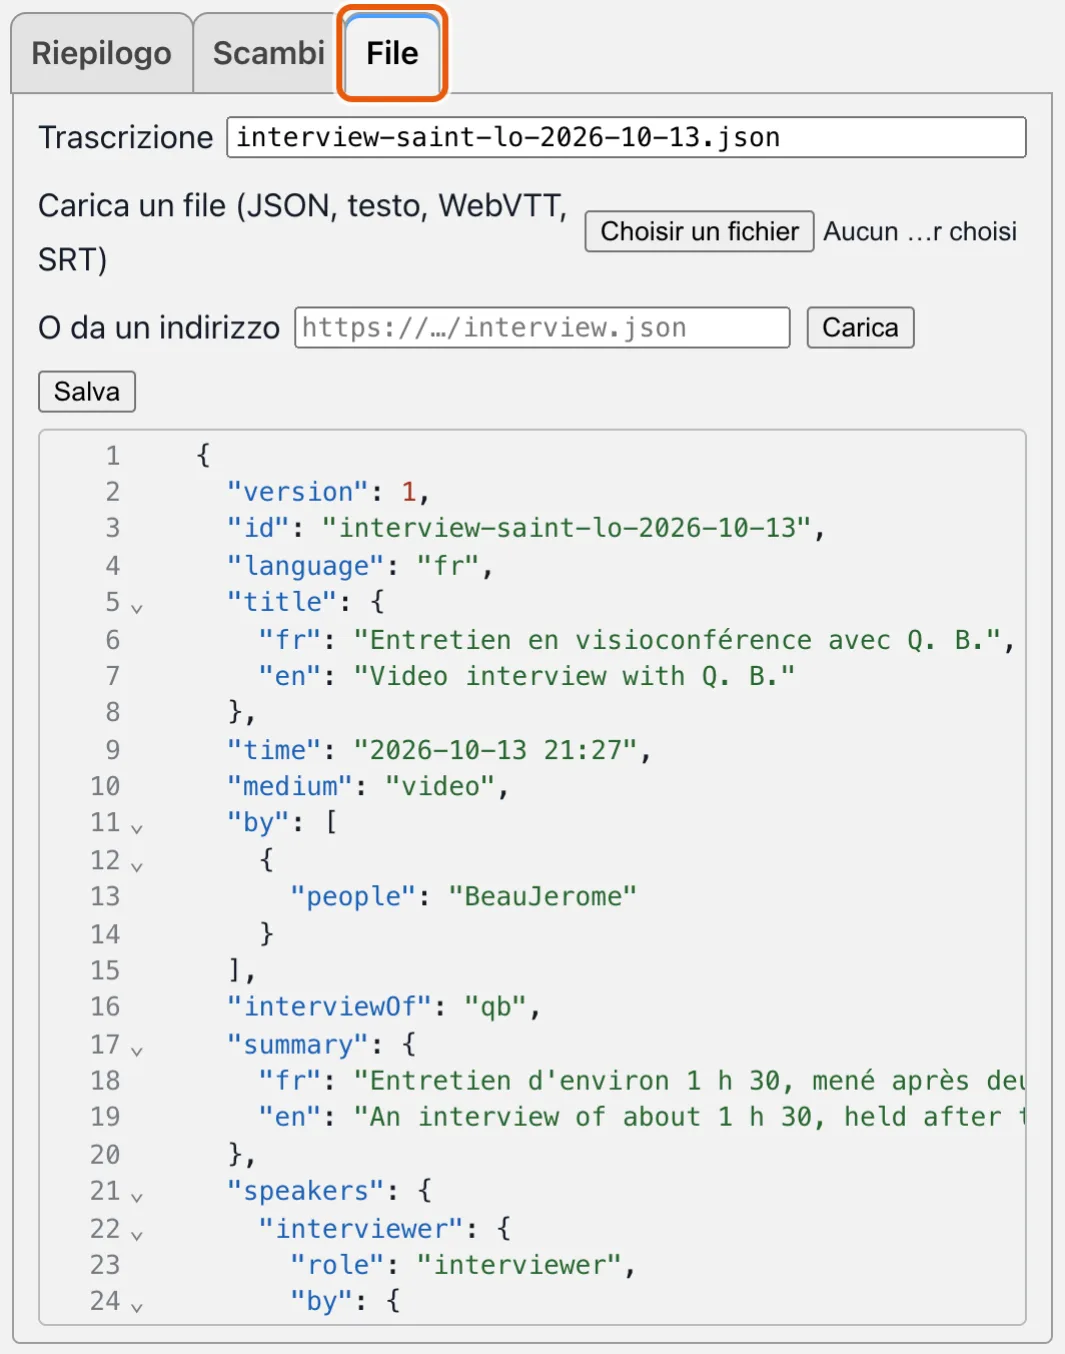
<rr0-interview-editor> ha tre gruppi: il Riassunto (titolo, testimoni, mezzo, data, intervistatori, descrizione), gli Scambi (l'intervista letta come un dialogo: chi ha detto cosa, il tempo di ogni turno in un suggerimento, i passaggi tolti anneriti con la loro ragione, chi non ha ancora approvato) e il File (la trascrizione come testo, completata secondo il suo schema, da caricare e salvare). È un blocco a parte, scaricato solo quando un caso ha un'intervista.
Importare una trascrizione che non è nel nostro formato#
La maggior parte delle trascrizioni viene da altrove. Nel gruppo File, «Carica un file» legge, oltre al JSON:
- WebVTT e SRT, come li scrive uno strumento di registrazione o un editor di sottotitoli: i tempi vengono conservati, il parlante è il tag
<v Nome>o unNome:prima del testo; - testo o Markdown con un nome prima di ogni turno:
Nome: …,[00:12:34] Nome: …,Nome (00:12:34): …,Q:/R:oQ./A.; una riga senza nome prosegue il turno precedente; - semplici paragrafi: un turno ciascuno, senza parlante né tempo.
I nomi trovati vengono abbinati a quelli dell'intervista: uno tra chi l'ha condotta è un intervistatore, uno che è testimone del caso è quel testimone. Altrimenti il primo a parlare è l'intervistatore e gli altri testimoni; Q chiede sempre e R o A risponde sempre. Tutti restano in attesa di approvazione (pending), e la nota dice da quale file proviene.
Tira a indovinare, e lo dice: ciò che sbaglia si corregge nel gruppo File. I file di elaboratori di testo e i PDF non vengono letti: salvali prima come testo. Due punti in una frase non sono presi per un parlante finché un nome non ritorna abbastanza spesso.
Parte tecnica: i file#
Quanto segue è per chi scrive questi file a mano, li genera o li legge nel codice. Nell'editor non serve conoscerne nulla.
L'evento nel caso#
In case.json, un'intervista è un evento il cui eventType è "interview".
| Campo | Significato |
|---|---|
id | Con cui altri elementi vi fanno riferimento |
time | Quando si è tenuta, come il caso scrive una data |
title | Come si chiama, in quante lingue si vuole |
summary | Ciò che ha stabilito, allo stesso modo |
medium | in-person, phone, video, chat, email, letter oppure other |
by | Chi l'ha condotta: un agente o più ({ "people": "…" } o { "org": "…" }) |
interviewOf | L'id dell'osservazione con cui si è tenuta, o un elenco se c'erano più testimoni |
url | Il file di trascrizione, se c'è, relativo al caso |
Il file di trascrizione#
Un semplice file JSON, il cui schema è interview.schema.json. Contiene tutto ciò che l'evento dice dell'intervista (il riassunto e il file restano uguali, comunque si modifichi) E ciò che è stato detto.
| Campo | Significato |
|---|---|
version, id, language | 1; l'id dell'intervista; la lingua in cui si è tenuta |
title, time, medium, by, interviewOf, summary | Gli stessi dell'evento |
speakers | Chi parla, con un id a scelta: { role, by?, title?, of? }. role è interviewer o witness; by l'agente dell'intervistatore; title come si chiama un testimone (le iniziali se non è nominato) e of l'osservazione che ha dato |
transcription | Come è stato ottenuto il testo: method (automatic o manual), engine e una note libera |
proofreading | Chi l'ha approvata, per parlante (vedi sotto) |
anonymization | Ciò che è stato sostituito (replaced) e ciò che ne prende il posto (marker) |
segments | I turni di parola, in ordine |
Un turno di parola
Ogni voce di segments è un turno.
| Campo | Significato |
|---|---|
speaker | Una chiave di speakers |
start, end | Secondi dall'inizio della registrazione, entrambi facoltativi: una trascrizione scritta a mano non ne ha, e un turno senza tempo non è nei sottotitoli |
text | Ciò che è stato detto, come testo semplice o HTML (un link, un titolo in corsivo, una parola straniera nella sua lingua: ciò che scriverebbe una pagina che lo pubblica), con l'escape di qualsiasi stringa JSON. Il formato dice chi parla e quando; il resto spetta all'HTML |
redacted | { reason }: l'intero turno è stato tolto dal file pubblicato. Non ha allora text |
parts | Al posto di text, quando è stato tolto solo un tratto: un elenco di { text } e { redacted }, in ordine |
refs | I momenti dell'osservazione di cui parla questo turno (vedi «Legami con l'osservazione») |
Ogni estratto qui sotto è in sola lettura, e ognuno conosce il formato: metti il cursore dentro un oggetto e premi Ctrl+Spazio (⌥+I su Mac) per elencare tutte le chiavi che potrebbero andarci, con ciò che il modello dice di ciascuna.
Un esempio
{
  "version": 1,
  "id": "interview-qb-1",
  "language": "fr",
  "title": { "fr": "Entretien avec Q. B." },
  "time": "2026-10-13 21:27",
  "medium": "video",
  "by": [{ "people": "BeauJerome" }],
  "interviewOf": "qb",
  "speakers": {
    "interviewer": { "role": "interviewer", "by": { "people": "BeauJerome" } },
    "witness": { "role": "witness", "title": "Q. B.", "of": "qb" }
  },
  "transcription": { "method": "automatic", "engine": "whisper.cpp large-v3-turbo" },
  "proofreading": { "interviewer": { "status": "approved" }, "witness": { "status": "pending" } },
  "segments": [
    { "speaker": "interviewer", "start": 0, "end": 4.2, "text": "Où étiez-vous ?" },
    { "speaker": "witness", "start": 5, "end": 9, "text": "Dans le parc.", "refs": [{ "at": 0.5 }] },
    { "speaker": "witness", "start": 10, "end": 18, "parts": [
      { "text": "Il n'y en a pas." },
      { "redacted": { "reason": { "fr": "Lieu précis" } } }
    ] },
    { "speaker": "interviewer", "start": 20, "end": 40, "redacted": { "reason": { "fr": "Vie privée" } } }
  ]
}
Nel codice#
@rr0/data legge e scrive gli stessi file: RR0Interview.fromEventJson / toEventJson per l'evento, fromFileJson / toFileJson per il file, e proofread dice se tutti hanno approvato. In UFO@home, InterviewFile.toVtt ricava sottotitoli da una trascrizione, InterviewFile.passagesAbout elenca i turni che raccontano un'osservazione e InterviewImport.parse legge un file altrui.
<rr0-interview>
Un'intervista letta come un dialogo: chi ha detto cosa, come lo dice il suo HTML, i passaggi rimossi come barre che dicono perché, l'ora di ogni turno al passaggio del puntatore, e i passaggi che raccontano un momento dell'osservazione come pulsanti che ci portano. Disegna nella pagina stessa, non in una radice ombra: gli stili della pagina raggiungono il testo e i suoi link.
<script src="https://ufoathome.org/lib/rr0-interview.mjs" type="module"></script>
<rr0-sighting id="player" src="case.json"></rr0-sighting>
<rr0-interview src="interview.json" player="player"></rr0-interview>
Un modulo a parte, leggero: contiene il dialogo e niente della scena né degli editor.
| Membro | Tipo | Cosa fa |
|---|---|---|
src | attributo | Il file dell'intervista, relativo alla pagina. I suoi link sono relativi ad esso. |
player | attributo | L'id di un <rr0-sighting> della pagina: un passaggio seguito fino al suo momento vi mostra l'osservazione, in quel momento. |
interview | proprietà | L'intervista mostrata, data direttamente invece che letta. |
documentUrl | proprietà | Ciò a cui sono relativi i link di un'intervista data direttamente. |
revealSegment(index) | metodo | Mostra quel turno e dove si trova. |
interviewseek | evento | Inviato, e propagato, quando un lettore segue un turno fino al momento dell'osservazione che racconta: detail è { sighting, at }. |
<rr0-interview-editor>
L'editor di un'intervista di un caso: il suo riassunto, i suoi scambi e il suo file di trascrizione. L'editor di casi lo mostra al posto dell'editor di registrazioni quando si sceglie un'intervista.
const interview = document.createElement("rr0-interview-editor")
interview.documentUrl = "https://example.org/cases/saint-lo/case.json"
interview.witnesses = [{ id: "qb", label: "Q. B." }]
interview.event = { type: "event", eventType: "interview", interviewOf: "qb" }
interview.addEventListener("interviewchange", event => console.log(event.detail.field))
Non è un modulo a parte: quello dell'editor di casi lo scarica, e lo definisce, la prima volta che si mostra un'intervista, poiché la maggior parte dei casi non ne ha.
| Membro | Tipo | Cosa fa |
|---|---|---|
event | proprietà | L'evento del caso che è l'intervista, modificato sul posto. |
witnesses | proprietà | Gli osservatori con cui può essersi tenuta, [{ id, label }]: una casella ciascuno, almeno una spuntata. |
documentUrl | proprietà | Ciò a cui è relativo l'url della trascrizione: l'indirizzo del caso. |
transcriptText | proprietà | La trascrizione come testo, una volta modificata o caricata; indefinita fino ad allora, quando viene letta dall'url dell'evento. |
readonly | attributo | Mostra soltanto l'intervista. |
revealSegment(index) | metodo | Apre il gruppo Scambi a quel turno e mostra dove si trova. |
interviewchange | evento | Inviato, e propagato, a ogni modifica: detail è { field, event, text? }, con il testo della trascrizione in text. |
interviewseek | evento | Inviato, e propagato, quando un lettore segue un turno fino al momento dell'osservazione che racconta: detail è { sighting, at }, con at in secondi dall'inizio dell'osservazione. |